AutoRAG Agent: 문서와 메신저 검색부터 출처 기반 답변까지

AutoRAG는 문서 폴더를 등록하고 자연어로 질문하면 관련 내용을 찾아주는 오픈소스 도구다. 현재 2.x 버전인 AutoRAG Agent는 HWP, PDF, DOCX 같은 파일을 검색할 수 있게 변환하고, 질문에 맞는 문서를 찾아 읽은 뒤 출처와 함께 답을 정리한다. 터미널에서 직접 쓸 수도 있고, Claude Code나 Cursor에 검색 도구로 붙일 수도 있다.
공식 README는 AutoRAG Agent를 사용 이력과 피드백을 참고하는 문서 검색 에이전트로 소개한다. 로컬 파일과 연결된 메일·메신저를 함께 검색하므로, 자료를 어느 앱에 저장했는지 몰라도 내용으로 찾을 수 있다.
AutoRAG는 원래 데이터에 맞는 RAG 파이프라인을 자동으로 찾아주는 Python 도구였다. 2.x부터는 문서를 검색하고 답변을 작성하는 에이전트로 개발되고 있으며, 기존 파이프라인 최적화 도구는 legacy/에서 별도로 유지보수한다.
AutoRAG로 할 수 있는 일
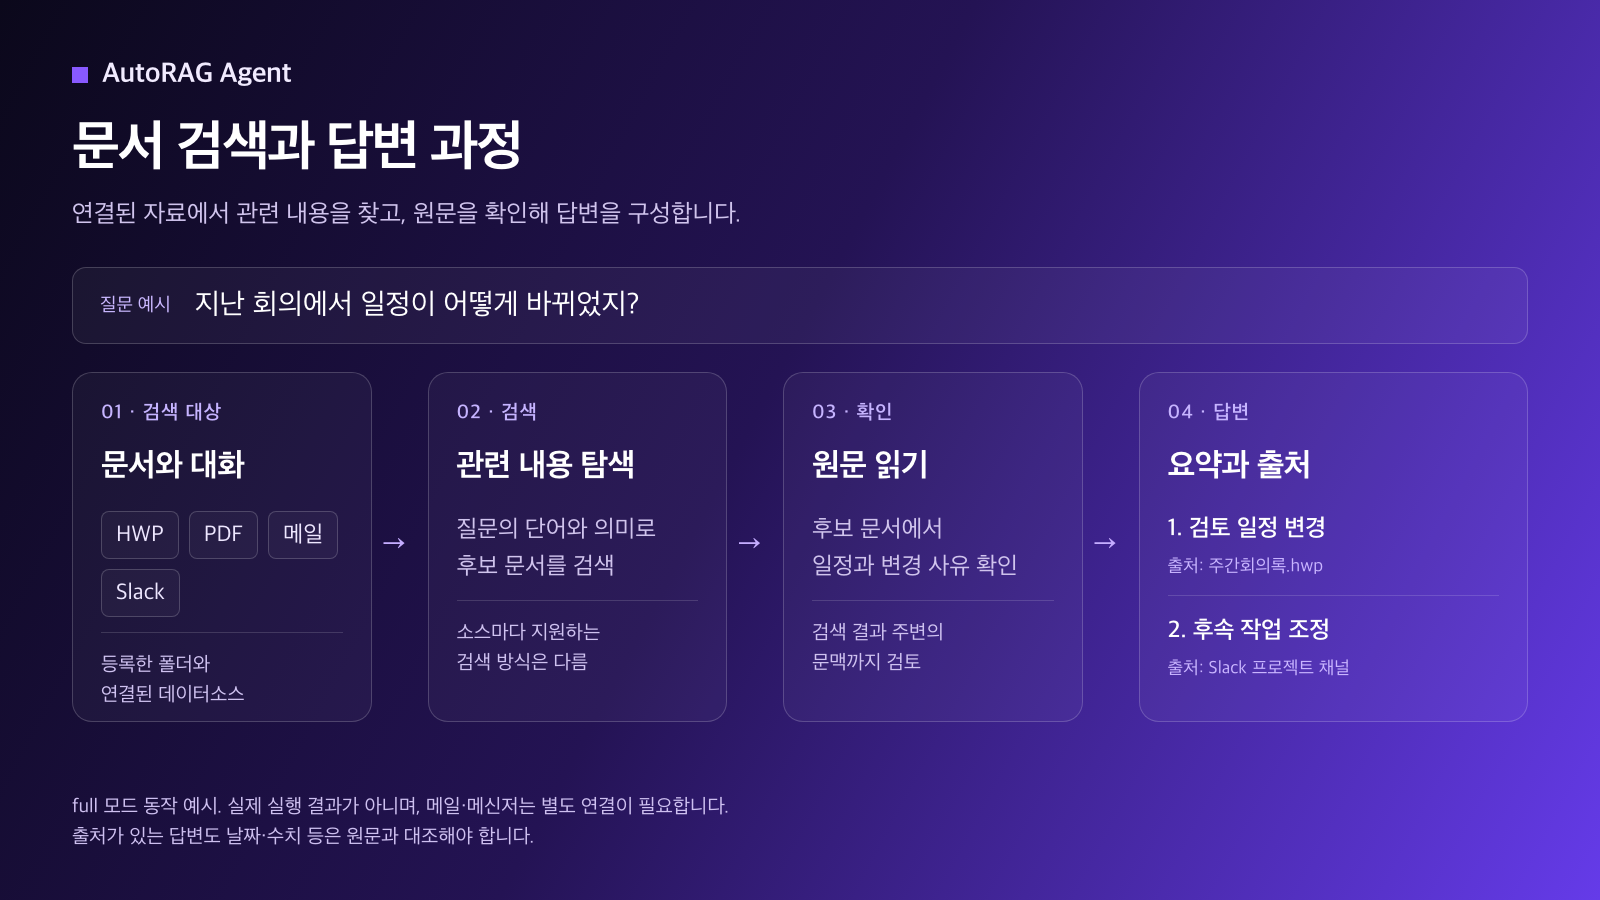
제안서, 회의록, 기술 노트가 여러 폴더에 흩어져 있다고 하자. 찾고 싶은 내용은 기억나지만 파일명이나 문서에서 썼던 표현은 기억나지 않을 수 있다. AutoRAG에서는 검색할 폴더를 등록한 뒤 "지난 회의에서 리스크 상태를 어떻게 바꾸기로 했지?"처럼 질문한다. 검색 결과만 반환하는 모드는 Lite, 대규모 언어 모델(LLM)이 문서를 읽고 답변까지 작성하는 모드는 full이다.
내용 기반 검색
AutoRAG는 문서를 검색 가능한 크기의 텍스트 조각, 즉 청크로 나누고 인덱스를 만든다. 임베딩은 이 텍스트를 의미 비교에 사용할 숫자 벡터로 바꾸는 과정이다. 검색할 때는 단어가 일치하는 정도를 보는 키워드 검색과, 질문과 내용의 의미가 가까운지 보는 벡터 검색을 활용한다. 두 검색의 순위를 합치는 방식이 hybrid 검색이다.
문서에 적힌 표현을 정확히 기억하지 못해도 질문의 의미로 관련 내용을 찾을 수 있다. 다만 코드나 식별자처럼 정확한 문자열을 찾는 질문에서는 벡터 검색이 원하는 결과를 뒤로 밀어낼 수 있다. 실제 검색 순위는 뒤의 Lite 실험에서 비교했다.
HWP·PDF·엑셀 지원
AutoRAG는 HWP/HWPX, PDF, DOCX, PPTX, XLSX 등의 본문을 마크다운으로 변환한다. 원본 파일은 원래 폴더에 남고, 변환한 텍스트를 검색에 사용한다.
사업비가 HWP 제안서의 표에 있고 세부 내역은 XLSX에 있다면, 인덱싱 단계에서 두 파일을 변환해 함께 검색할 수 있게 한다. HWP의 표 안 텍스트나 XLSX의 행 구조가 변환 결과에 남는지도 확인할 필요가 있다.
지원 형식이라고 모든 파일을 읽는 것은 아니다. 정부 양식 HWP 일부는 파싱에 실패했고, 이미지로만 된 PDF는 기본 설정에서 텍스트를 추출하지 못했다. 사용할 문서가 제대로 변환되는지 먼저 확인해야 한다.
답변 생성과 출처 확인
full 모드는 검색으로 찾은 후보 문서를 에이전트가 직접 열어보고, 질문에 필요한 내용을 항목별로 정리한다. 답과 함께 출처 경로를 주므로 원문을 다시 확인할 수 있다. 공식 README는 이 검색, 원문 확인, 답변 작성 과정을 AutoRAG Agent의 기본 동작으로 설명한다.
같은 주제를 다룬 문서가 여러 개라면 각 문서에서 관련 내용을 모아 답변을 구성한다.
검색 스킬 문서에 따르면 autorag evidence로 이전 검색의 원문 발췌, 출처, 검색 방식 등을 확인할 수 있다. 답변에 적힌 요약만으로 판단하기 어려울 때 원문과 대조하는 용도다. 이 명령은 이번 실험에서는 직접 검증하지 않았다.
원본 파일의 이름이나 폴더 구조는 바꾸지 않는다. 출처가 붙은 답변도 확인은 필요하다. 긴 업무 문서에서는 필요한 내용을 놓치거나 원문과 다른 표현으로 답한 사례가 있었다.
검색 메모리와 피드백
README에 따르면 메모리에 이전 검색에서 유용했던 방법을 기록하고, 비슷한 질문에 답할 때 참고한다. 사용자는 번호가 붙은 답변 항목에 유용했는지 아닌지를 피드백할 수 있다. 공식 아키텍처 설명에서 말하는 self-evolving은 이 메모리와 피드백 동작을 가리킨다.
다만 이번 실험에서 +1과 -1 피드백을 준 뒤 다시 검색했을 때 결과 순위는 같았다. 확인한 구현에서는 full 모드의 LLM에 주는 힌트로 쓰였으며, 반복 사용만으로 검색 정확도가 높아지는지는 검증하지 못했다.
Claude Code 연동
이미 Claude Code나 Cursor로 일하고 있다면 Lite 모드를 검색 도구로 붙일 수 있다. AutoRAG가 문서 변환과 검색을 맡고, 기존 에이전트는 반환된 청크를 읽어 답변을 작성한다.
예를 들어 Claude Code에 제안서 내용을 확인해 달라고 요청했을 때, 파일 형식별 변환 명령을 매번 고르게 하는 대신 준비된 인덱스에서 관련 내용을 찾게 할 수 있다. 저장소에는 이 용도의 설치·검색 스킬이 포함돼 있다. 이 글에서도 Lite 스킬을 붙인 Claude Code와 grep 및 변환기만 쓰는 Claude Code를 비교했다.
Lite 자체는 답변 생성용 LLM을 호출하지 않고 임베딩도 로컬에서 처리한다. 다만 검색 결과를 Claude Code 같은 외부 에이전트에 넘기면, 그 내용은 해당 에이전트의 모델 입력으로 사용된다.
증분 인덱싱과 중복 제외
폴더에 문서를 추가하거나 내용을 수정한 뒤에는 refresh로 인덱스를 갱신한다. 인덱싱을 담당하는 MinSync가 바뀐 청크만 다시 임베딩하므로, 기존 문서 전체를 매번 처음부터 처리하지 않는다.
중복 판별 도구 dupey는 본문이 완전히 같은 문서를 찾아 인덱싱 대상에서 제외한다. 원본 파일을 삭제하는 동작은 아니며, 어떤 파일을 남길지는 수정 시각으로 정한다. 따라서 방금 복사한 파일이 원본보다 우선될 수도 있다.
메일·메신저 연동
문서 폴더 외에 Slack, Notion, 메일, 카카오톡 등을 연결하는 기능도 제공한다. 회의록과 메신저의 후속 논의를 함께 찾고 싶을 때 사용할 수 있다.
여러 소스를 연결할 때도 각 도구가 관리하는 저장소와 검색 기능을 이용한다. 예를 들어 Slack은 slacrawl의 아카이브를, Obsidian은 qmd를 사용한다. 외부 자료 전체를 AutoRAG 전용 DB로 옮길 필요는 없다. 다만 로컬 문서는 검색용 텍스트와 인덱스를 만들고, 클라우드 드라이브 연동에는 로컬 미러가 사용되므로 모든 연결이 복사 없이 동작한다는 뜻은 아니다. 데이터소스 문서에 소스별 저장·검색 방식이 정리돼 있다.
연동하려면 데이터소스별 CLI나 로컬 아카이브를 준비해야 한다. 소스마다 지원하는 검색 방식도 다르다. 예를 들어 Slack과 Notion은 어휘 검색을 사용한다. 외부 데이터소스 연동은 이번 실험에서 직접 검증하지 않았으며, 아래 연동 표는 v2.5.2 공식 문서를 기준으로 정리했다.
| 데이터소스 | 백엔드 | 검색 방식 |
|---|---|---|
| 카카오톡 | katok CLI | BM25, 시맨틱, hybrid |
| 메일 (Gmail/IMAP/Maildir) | mailcrawl | BM25, 시맨틱, hybrid |
| 로컬 메일 내보내기 | 내장 .mbox / .eml 파서 | 어휘 |
| RSS·뉴스 | HTTP 폴링 | 어휘 |
| Obsidian | qmd | BM25, 시맨틱 |
| Discord | discrawl | BM25, 시맨틱, hybrid |
| Slack, Notion, WhatsApp, Telegram | slacrawl, notcrawl, wacrawl, telecrawl | 어휘(FTS5)만 |
| GitHub | REST API | Issues/PR, 어휘 |
| 클라우드 드라이브 | rclone | Google Drive, OneDrive, Dropbox |
| 사진·스크린샷 | clawgallery | OCR + 비주얼 |
| macOS Spotlight | mdfind | 시스템 인덱스 |
BM25와 FTS5는 어휘 검색, 시맨틱은 의미 기반 검색을 가리킨다.
Lite와 full 모드
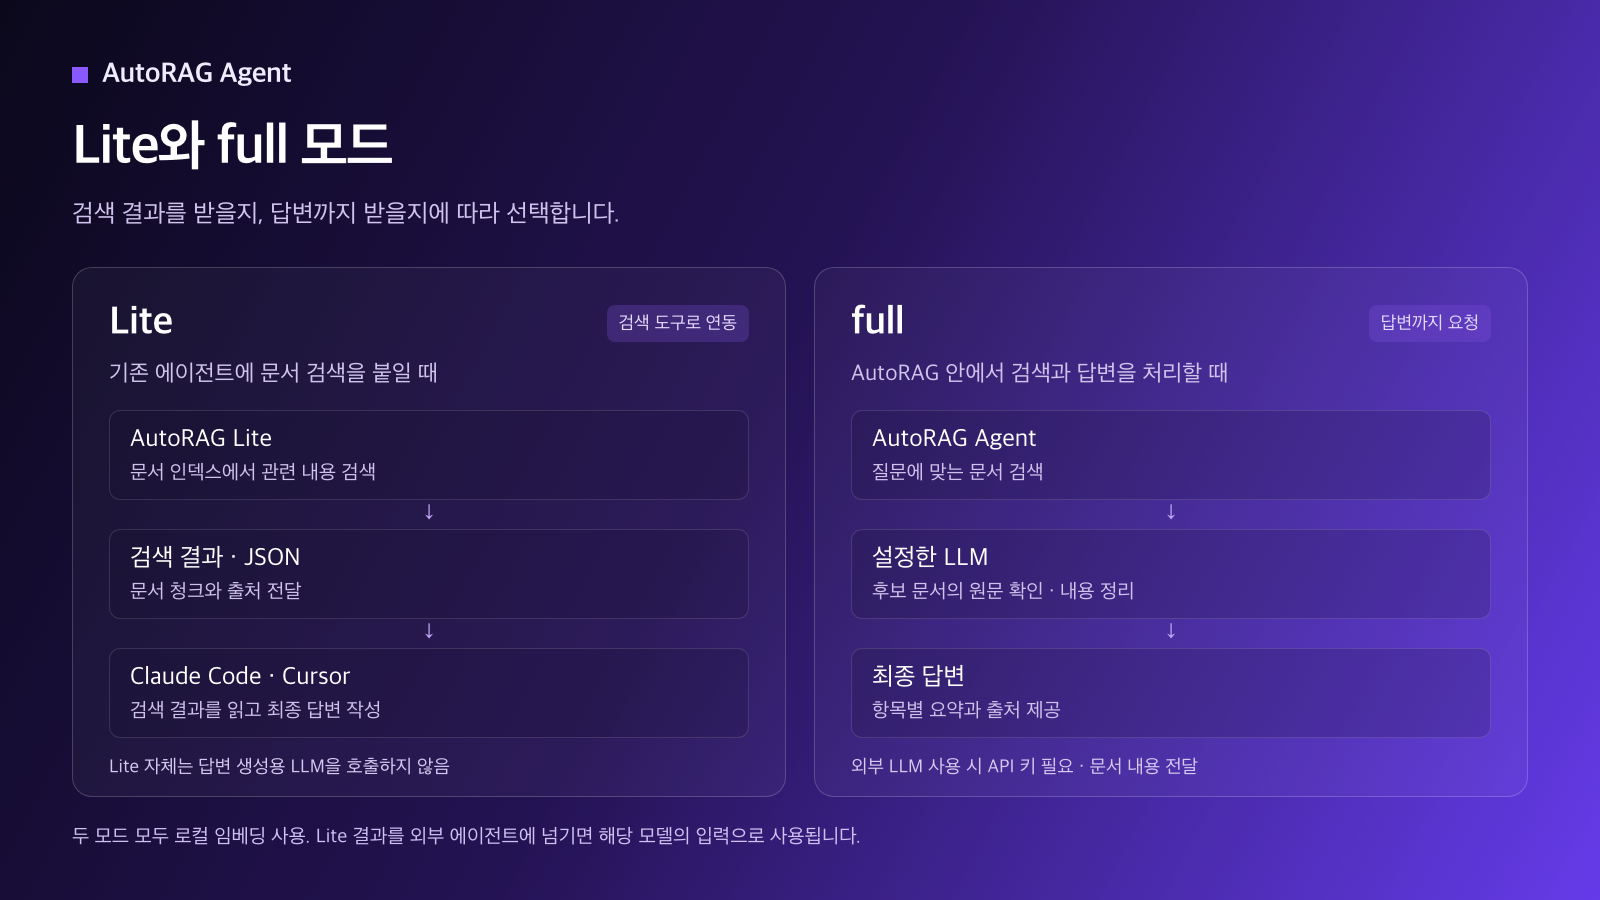
사용 순서는 검색할 폴더 등록, refresh로 인덱스 생성, 질문 입력이다. 검색 결과를 기존 에이전트에서 활용하려면 Lite, AutoRAG에서 답변까지 받으려면 full을 사용한다.
| 모드 | 입력과 결과 | 쓰는 상황 |
|---|---|---|
| Lite | autorag lite retrieve "질문"으로 관련 문서의 청크를 JSON으로 받는다 | Claude Code나 Cursor가 검색 결과를 읽고 답을 만들 때 |
| full | autorag search "질문"으로 출처가 붙은 답을 받는다 | AutoRAG 안에서 검색부터 답변 작성까지 처리할 때 |
사용자가 청커, 임베더, 벡터 DB를 직접 선택할 필요는 없다. 임베딩 모델(Qwen3-Embedding-0.6B)은 로컬에서 실행한다. full 모드는 Pi 에이전트 프레임워크로 구현했으며, 설정한 모델 하나가 검색부터 답변 작성까지 맡는다. 외부 LLM을 설정하면 해당 서비스의 인증 정보가 필요하고, 답변에 사용하는 문서 내용이 그 서비스로 전달된다. 코드에는 로컬 모델을 사용하는 경로도 있다.
CLI·TUI·라이브러리
단발성 질문은 CLI로 보내고, 터미널에서 대화하며 사용하려면 autorag tui를 실행한다. TUI는 베타다. TypeScript 라이브러리도 제공하므로 애플리케이션에서 검색을 호출하고 답변과 출처를 받아 사용할 수 있다. README의 사용 예시에서 두 방식을 확인할 수 있다.
다른 사용자와 검색을 공유하는 SimpleX 기반 P2P 기능도 있다. 별도로 활성화하고 상대방 신뢰, 질의 승인, 공유 정책을 설정하는 방식이다. 이 글에서는 CLI와 에이전트 스킬을 사용했으며, TUI·라이브러리·P2P 연동은 직접 테스트하지 않았다.
MCP 서버는 제공하지 않는다.
내부 구성
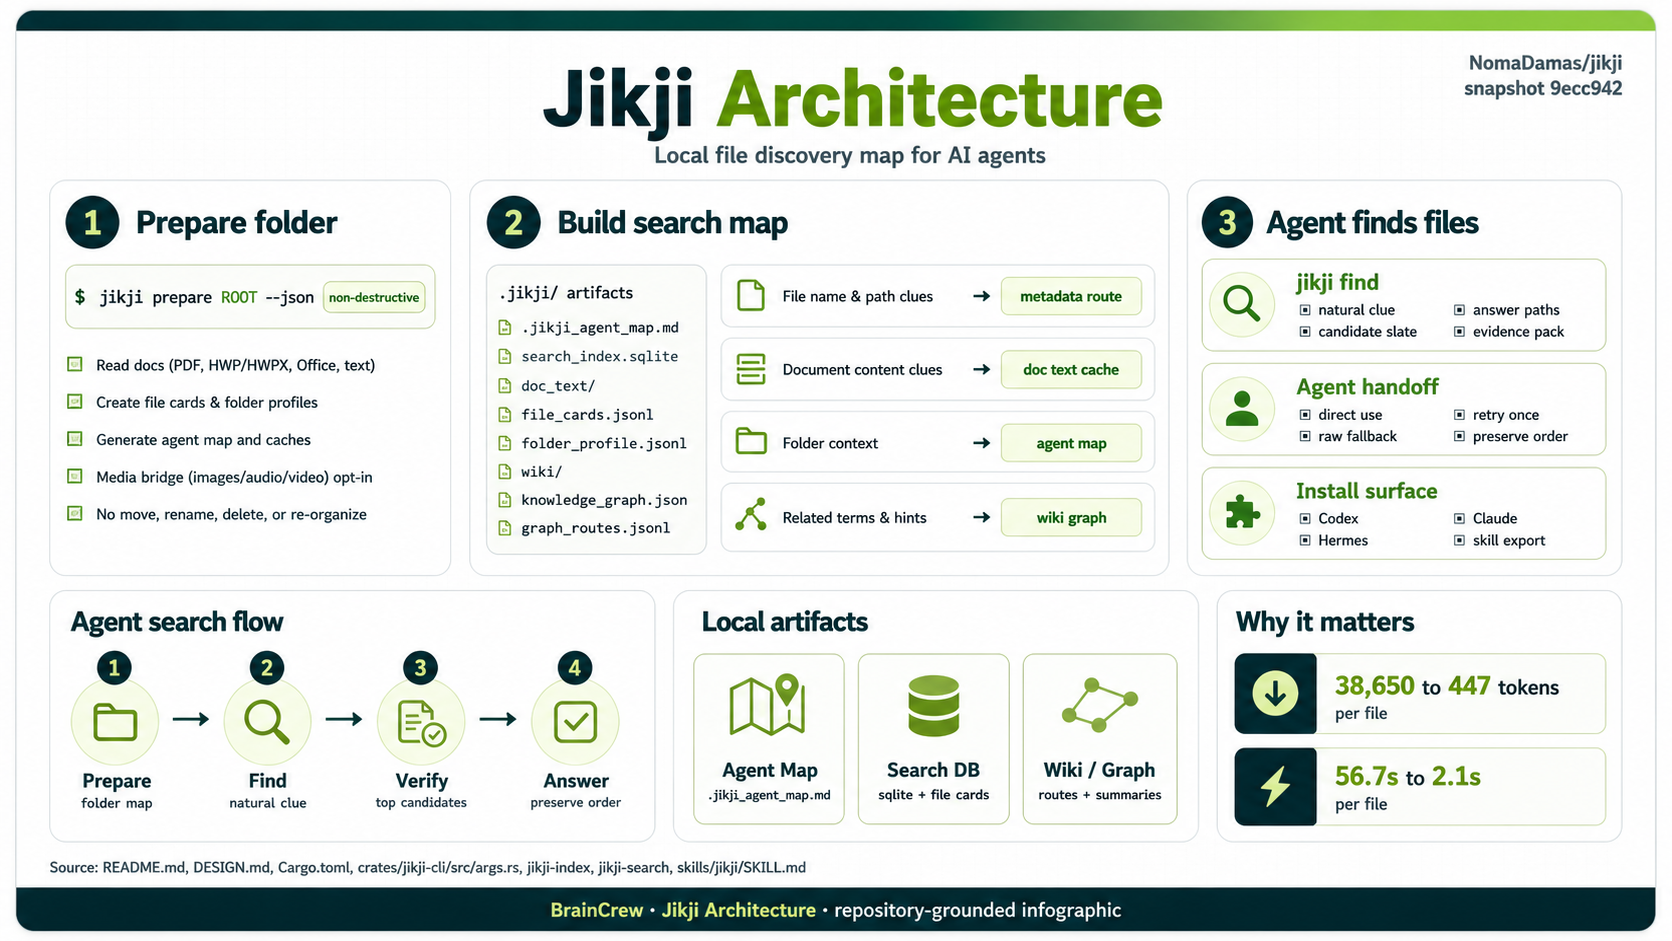
앞선 연재에서 다룬 MinSync, jikji, dupey는 AutoRAG의 문서 처리 단계에 연결돼 있다. autorag refresh를 한 번 돌리면 문서 변환부터 검색 인덱스 생성까지 순서대로 실행된다.
autorag refresh
  -> 파서: HWP/HWPX, PDF, DOCX, PPTX, XLSX, EML, 텍스트를 마크다운으로 변환해 .autorag/parsed/ 에 미러링
  -> dupey: 본문 해시가 같은 exact 중복 중 최신 파일 하나만 남기고 제외
  -> MinSync: 바뀐 청크만 임베딩, BM25 + 벡터 인덱스를 LanceDB에 유지
  -> jikji: 원본 폴더의 .jikji/ 에 파일 카드와 에이전트 맵 생성
refresh --json 진단에 duplicate-excluded가 찍히고, 워크스페이스에 .autorag/minsync/가 생기고, 원본 폴더에는 .jikji/가 생긴다. 이 폴더에 파일 카드와 에이전트 맵을 저장하며, 원본 파일은 수정하지 않는다. dupey 글에서 "최신 수정 시각 파일이 남는다"고 적었던 동작도 그대로였다. 원본 글을 cp로 복사했더니 방금 만든 사본이 인덱싱되고 원본이 빠졌다.
MinSync는 임베딩과 검색 엔진 자체를 맡는다. AutoRAG의 hybrid 검색은 MinSync 안에서 키워드·벡터 검색 순위를 RRF(k=60)로 합친다. jikji는 full 모드에서 jikji_find라는 도구로 에이전트에게 노출된다. agentdir만은 런타임에 연결돼 있지 않다. 원본과 에이전트용 뷰를 분리한다는 설계 관점을 공유할 뿐이다.
설치와 첫 검색
bun install -g @autorag/librarian@2.5.2
autorag lite init --search-paths ~/Documents/reports --workspace ~/autorag-ws
autorag lite refresh --json
autorag lite retrieve "작년 제안서 사업비" --top-k 5 --json
Node 24 이상이 필요하다. PDF 파싱에는 Java 11 이상, jikji 컴파일에는 Rust 툴체인이 필요하다. 실험 환경에서는 첫 refresh에서 MinSync와 jikji를 cargo install로 빌드했다. MinSync는 사용 가능한 cargo가 있으면 빌드를 시도하고, 그렇지 않으면 배포 바이너리를 받는 경로도 있다. 블로그 글 23편짜리 폴더에서 첫 refresh가 753초였는데, 파싱이나 임베딩이 아니라 대부분 컴파일 시간이었다.
실험 대상과 비교 방법
블로그 마크다운 23편, 개인 노트 마크다운 338편, 업무 문서 81개를 준비했다. 업무 문서에는 HWP, PDF, DOCX, PPTX, XLSX가 섞여 있다. 업무 문서 수는 단계마다 줄었다. 첫 인덱싱은 81개로 돌렸고, 이미지만 있어 0자로 파싱된 PDF 3개와 PPTX 2개를 제외했다. 남은 76개에서 NaN 임베딩 오류를 낸 논문 PDF 1개를 더 빼고, 75개가 남은 폴더로 검색 실험을 했다. 그 75개 중 파서 실패 6개, 크기 초과 1개, 중복 제외 3개를 빼고 실제로 검색 가능했던 문서는 65개다.
먼저 Lite 자체의 인덱싱 시간과 검색 순위를 확인했다. 이어서 같은 질문에 답하도록 Claude Code에 Lite 스킬을 붙인 경우와 grep·문서 변환기만 사용한 경우를 비교했다. 마지막으로 AutoRAG full 모드에서 모델별 답변을 비교했다. Lite의 검색 시간과 에이전트의 전체 답변 시간은 구분해서 봐야 한다.
명령과 실험 결과는 v2.5.2(2026-09-20) 기준이다. 소개 중 외부 데이터소스, TUI, 라이브러리, P2P 기능은 공식 문서를 참고했으며 직접 실험한 범위에는 포함하지 않았다.
Lite 검색 결과
인덱싱·검색 시간
| 폴더 | 파일 | 첫 refresh | 무변경 refresh | 파일 1개 수정 후 | retrieve |
|---|---|---|---|---|---|
| 블로그 마크다운 | 23개, 356KB | 753초 (컴파일 포함) | 2.4초 | 19.6초 | 1.2~1.4초 |
| 개인 노트 마크다운 | 338개, 6MB | 파싱 + 임베딩 629초 | 1.3초 | ||
| 업무 문서 (HWP/PDF/DOCX/PPTX/XLSX) | 81개, 337MB | 파싱 253초 + 임베딩 458초 | 1.3초 |
업무 문서의 파일 수는 처음 준비한 81개 기준이다. retrieve 시간은 파일을 제외한 뒤 실제로 검색 가능했던 65개 문서를 대상으로 측정했다.
증분 refresh에서는 변경된 청크만 처리했다. 파일 하나를 고치고 사본 하나를 추가한 뒤 다시 돌리니 청크 3개만 다시 임베딩됐다.
노트 338개를 인덱싱할 때는 진행 상태를 알기 어려웠다. 임베딩 단계에서 10분 넘게 CPU 사용률이 0%여서 멈춘 줄 알고 프로세스를 두 번이나 죽였다. 스택을 찍어 보니 임베딩 계산이 아니라 MinSync 0.4.5가 LanceDB에 작은 커밋을 수천 번 하면서 디스크를 기다리는 시간이었다. lite status는 inFlight: true만 보여주고 진행률은 알려주지 않으니, 파일이 수백 개 이상인 폴더를 처음 인덱싱할 때는 이 상태만 보고 멈췄다고 판단하기 어렵다.
검색 품질
문서의 표현을 바꿔 질문해도 관련 글을 찾았다. "변경된 파일만 다시 임베딩해서 인덱스를 최신으로 유지하는 방법"을 넣으면 MinSync 글이 1위로 나오고, 영어로 "how does the agent avoid repeated ls and grep loops"를 넣어도 jikji 글이 1위다.
반면 정확한 토큰을 찾는 질문에는 약했다. 0o444를 넣었더니 그 문자열이 없는 Oracle 글이 1위였고, 정작 0o444가 들어 있는 청크는 5위였다. 검색 확인용으로 글 끝에 추가한 "보라색 코끼리 프로토콜은 분기마다 인덱스를 재검증한다"라는 문장을 찾게 했을 때도 정답 청크는 2위에 그쳤다. 검색 방식과 점수 해석은 구분할 필요가 있다. 로컬 문서에 등록된 검색 방식이 벡터와 hybrid뿐이고 BM25 단독 경로는 없다(src/agent/agent.ts:437-443). 그리고 방식별로 min-max 정규화를 하기 때문에 1위 점수는 관련도와 상관없이 항상 1.000이 된다. 그래서 점수만 보고 "관련 문서가 없다"고 판단할 수가 없다.
Lite를 Claude Code에 붙이기
저장소의 skills/autorag-lite-setup과 skills/autorag-lite-search 폴더를 프로젝트의 .claude/skills/에 복사하면 Claude Code가 autorag lite retrieve를 검색 도구로 쓰기 시작한다. README에는 이 설치 방법이 따로 없어서 직접 복사해야 한다. 스킬 문서의 lite report JSON 스키마 설명에는 필수 필드 두 개(results[].evidence, mapping[].content)가 빠져 있어서 문서대로 따라 하면 검증 오류가 나는데, 오류 메시지는 어느 필드가 문제인지 알려주지 않는다.
grep 에이전트와 비교
같은 질문을 두 에이전트에게 줬다. 하나는 Lite 스킬만 쓰고, 다른 하나는 grep과 변환기만 쓴다. 둘 다 폴더를 처음 보는 상태였고, 질문은 문서에 나오는 단어를 일부러 피해서 바꿔 썼다.
| 폴더 | 질문 수 | grep 에이전트 | Lite 에이전트 |
|---|---|---|---|
| 블로그 마크다운 23편 | 6 | 6/6 정답, 도구 3회, 47초, 6.2만 토큰 | 6/6, 9회, 100초, 10.4만 |
| 개인 노트 338편 | 8 | 8/8, 7회, 115초, 6.8만 | 8/8, 13회, 189초, 9.3만 |
| 업무 문서 75개 | 6 | 6/6, 8회, 136초, 7.4만 | 6/6, 15회, 183초, 9.5만 |
세 번 모두 정답률은 같았고, 시간과 토큰은 grep 쪽이 적게 들었다. 솔직히 예상 밖이었다. 338편 실험에서는 grep 에이전트의 첫 키워드가 세 번 빗나갔는데, 파일명을 단서로 문서를 찾았다. 이번처럼 파일명으로 내용을 짐작할 수 있는 폴더에서는 Claude Code와 grep만으로도 모든 질문에 답할 수 있었다.
HWP 변환에서는 Lite 쪽이 나았다. 업무 문서 실험에서 grep 에이전트는 hwp5txt가 표 안 텍스트를 버리는 바람에 HWP 하나를 다시 변환해야 했고, XLSX는 sharedStrings.xml을 뜯어서 열 이름만 겨우 읽었다. AutoRAG의 파서는 같은 HWP를 표까지 8,022자로 뽑았다. 다만 XLSX에서도 행 구조가 보존된다고 일반화할 수는 없다. 뒤의 후속 실험에서는 한국어 문자 참조와 행·열 관계가 제대로 복원되지 않은 파일을 확인했다.
Lite 검색 결과를 읽는 과정에도 불편한 점이 있었다. 검색 결과 top-5 JSON이 58KB나 됐고, 청크 안 어디에 답이 있는지 표시도 줄 번호도 없어서 6문항 중 5문항은 파일을 다시 열어야 했다. 청크가 표지와 머리말 쪽에 몰리다 보니 긴 문서의 중간 내용은 잘 올라오지 않았고, 무관한 문서 하나(AIPMO 1.5_산출물.docx)가 질문 4개에서 반복해서 상위에 나왔다. "공공기관" 설문을 물었는데 금융기관 설문이 1, 2위로 나온 일도 있었다.
설정 문제를 해결하는 과정에서는 벡터 검색의 효과를 확인할 수 있었다. MinSync를 AutoRAG를 거치지 않고 직접 돌렸더니, AutoRAG가 기록하는 임베딩 identity 파일이 없다는 이유로 벡터 검색이 별도 경고 없이 빠지고 hybrid만 돌았다. 그 상태에서는 가장 어려운 질문의 정답이 4위(점수 0.08)였는데, autorag lite refresh --method minsync로 identity를 기록하고 나니 같은 질문이 1위로 올라왔다.
full 모드의 답변 품질
답변 생성과 인증
full 모드는 Lite의 검색 결과를 LLM이 읽고 답으로 정리한다. 먼저 추론 기능을 끈 상태로 예비 답을 내고, 이어서 추론 기능을 켜고 내용을 검증한 뒤 최종 답을 낸다. 에이전트에게는 bash가 실제 셸로 주어지기 때문에 후보 문서를 cat으로 열어 확인할 수 있다. 최종 답은 항목별로 번호를 붙여 정리하고 출처 경로를 함께 제공한다.
이번 실험에서는 외부 LLM의 API 키를 환경변수로 제공했다. resolveRoleAuth에는 외부 제공자의 환경변수 인증과 로컬 런타임 인증 경로가 있다(src/cli/config.ts:1303). Claude Code나 Codex에 로그인돼 있다는 이유만으로 해당 인증이 AutoRAG에 연결되는 것은 아니다.
앞의 Lite 예제에서 init과 refresh를 마쳤다면 같은 설정과 인덱스를 full에서도 사용한다. OPENAI_API_KEY를 환경변수로 설정한 뒤, 현재 셸에서 사용할 모델을 지정하고 검색한다.
export AUTORAG_MODEL_PROVIDER=openai
export AUTORAG_MODEL_ID=gpt-5.6-terra
autorag health --json
autorag search "작년 제안서 사업비" --json
모델별 결과
gpt-5.6-sol, terra, luna를 사고 수준 medium으로 맞추고 같은 질문을 돌렸다.
| 폴더 | 질문 | terra | luna | sol |
|---|---|---|---|---|
| 블로그 23편 | 1 | 33초, 정답 | 31초, 정답 | 57초, 정답 |
| 개인 노트 338편 | 8 | 평균 42초, 7/8 + 부분 1 | 평균 51초, 8/8 | 평균 56초, 7/8 + 부분 1 |
| 업무 문서 75개 | 6 | 평균 39초, 3/6 + 부분 3 | 평균 36초, 1/6 + 부분 3 | 평균 74초, 2/6 + 부분 2 |
Lite의 검색 시간은 약 1.3초였다. full은 검색 뒤 원문 확인과 답변 작성까지 수행하므로 수십 초가 걸렸고, 업무 문서에서 sol의 평균 응답 시간은 74초였다. 두 수치는 처리 범위가 다르다.
full 모드는 여러 글의 내용을 모아 답했다. 338편 실험에서 "미리 정리해 둔 지식 베이스 방식의 실패 모드"를 물었을 때 grep 에이전트는 글 하나를 찾아 답했고, full은 같은 주제를 다룬 글 두 편의 표를 모두 인용했다. "1인 개발자의 형상 관리 습관"을 물었을 때는 다른 글에 있던 "매일 커밋"을 보조 습관으로 덧붙이기까지 했다.
요약 과정에서 원문 표의 3.74배를 3.7배로 반올림한 사례가 있었다. 원문의 자릿수까지 보존해야 하는 용도라면 확인할 부분이지만, 이 차이만으로 오답이라고 보기는 어렵다. 원문에 적힌 구체적인 이유를 일반적인 설명으로 바꾼 문항도 있었다. luna는 예비 답에서 다른 벤치마크 수치를 영화 추천 수치로 잘못 짚었다가 최종 답에서 스스로 정정했다.
업무 문서에서는 full 모드의 정답률이 낮았다. 같은 6문항에 grep 에이전트와 Lite 에이전트는 전부 정답을 냈는데, 세 모델 모두 절반 이하였다. 회의록에 적힌 리스크 상태 흐름 "Open → 조치중 → Close"를 terra와 luna는 찾지 못했고, 대신 "신규 등록 → 추적·조치 → Close" 같은 표현을 만들어 냈다. 회의에서 바꾸기로 한 표현은 "확정"인데 luna와 sol은 "승인"이라고 답했다. RFP에는 종료 시점이 "계약 체결 후 ~ 2026년 12월 31일"이라고 적혀 있는데 terra와 sol은 "명시되지 않았다"고 했다. 학생 과제물의 데이터 출처(EPSIS)는 terra만 맞혔다. sol은 문서에 없는 KOSIS를 답했고, luna는 예비 답에서 맞게 EPSIS라고 했다가 최종 답에서 "근거를 확인할 수 없다"며 스스로 물러섰다.
긴 문서에서는 검색 누락과 답변 오류가 함께 관찰됐다. Lite 실험에서는 필요한 중간 청크가 검색 상위에 잘 나오지 않아도 Claude Code가 파싱된 문서를 다시 열어 답을 찾았다. full 모드에서는 원문에 없는 표현을 쓰거나 "확인되지 않는다"로 마무리한 경우가 있었다. 마크다운 폴더에서는 같은 문제가 두드러지지 않았다. 다만 비교에 사용한 모델과 원문 재탐색 방식도 달랐으므로, 이번 실험만으로 문서 길이, 검색 결과, 에이전트의 후속 탐색이 각각 얼마나 영향을 줬는지는 확인하지 못했다.
기본 설정에서는 web_search 도구가 켜져 있다. sol이 블로그 폴더를 검색하면서 폴더에 없는 "최신 MinSync 공식 문서"를 근거로 인용한 적이 있는데, 웹에서 가져온 내용이었다. 웹 검색을 끄는 방법은 뒤의 「문서 전송과 웹 검색」에 정리했다.
문서 찾기와 표 검색을 다시 해봤다
어떤 작업에 쓸 만한지 좁혀 보기 위해 9월 23일에 v2.5.2 Lite로 추가 실험을 했다. AutoRAG 글을 제외한 공개 기술 블로그 23편에 질문 15개를 준비했다. 답이 있는 13개는 검색 전에 기대 문서를 지정했고, 나머지 2개는 코퍼스에 답이 없는 질문이었다. top-k를 1·3·5·10으로 바꿔 각각 실행했다. 여기서 측정한 것은 필요한 문서를 찾았는지이며, LLM의 최종 답변 정답률은 아니다.
용어는 잊었지만 내용을 기억할 때
표현을 바꾼 한국어 질문 3개와 영어 질문 3개는 모두 기대 문서를 1위로 찾았다. “아직 채점하지 못한 항목을 실패한 항목과 섞으면 성적표가 왜 왜곡될까?”라는 질문으로는 평가의 0점과 측정 불가를 구분한 글을 찾았다. 영어로 늦게 돌아온 작업자가 다른 작업자의 결과를 덮지 못하게 하는 방법을 물었을 때도 한국어 lease fencing 글이 나왔다.
다만 첫 청크가 바로 답은 아니었다. 평가 관련 질문에서는 집계식을 설명한 부분이 아니라 글 후반의 주의점과 참고자료가 먼저 나왔다. 이 경우 AutoRAG로 문서 위치를 찾고 그 원문을 읽는 흐름이 유용했다. 특정 식별자를 이미 알고 있을 때는 달랐다. 0o444 검색은 그 문자열이 없는 Oracle 글을 1위로 반환했지만, 같은 토큰으로 rg를 실행하면 해당 문자열을 포함한 agentdir 글만 나왔다.
이 결과만으로 벡터 검색의 우위를 주장할 수는 없다. 같은 질문을 동일한 MinSync 인덱스의 BM25 단독 검색으로도 실행했더니, top-5에서 필요한 문서를 모두 찾은 질문 수는 AutoRAG와 똑같이 12/13개였다. 일부 질문의 순위는 달랐지만 이 작은 코퍼스에서는 검색 가능한 범위가 크게 벌어지지 않았다. BM25 비교는 MinSync를 직접 호출한 것이며, Claude Code의 전체 작업 성능을 다시 비교한 실험은 아니다.
개인 블로그 마크다운 307편에서도 별도로 준비한 7개 질문을 비교했다. “Which branches does the solo developer use for production and individual features?”로 물으면 AutoRAG는 「1인 개발자의 생산성 스택」을 1위로 찾았고, top-3에는 main과 feature/*의 용도를 적은 본문이 포함됐다. 같은 질문의 BM25 top-5에는 해당 글이 없었다. 반대 사례도 있었다. 지식베이스에 과거 설계 결정의 이유를 보존하는 법을 영어로 물었을 때 BM25는 기대한 「LLM Wiki와 ADR」을 1위로 찾았지만, AutoRAG는 top-5에서 놓치고 top-10에서야 찾았다. 영어 질문이라고 항상 벡터 결합이 유리하지는 않았다.
질문을 나누고 top-k를 바꿨을 때
“원본 복제에 드는 저장 공간과 문서 수정 후 재임베딩 비용을 각각 줄이는 도구”를 한 질문으로 묶으면 top-10에서도 MinSync 글만 찾고 agentdir 글은 놓쳤다. 저장 공간과 재임베딩을 별도 질문으로 나누자 각각 top-3에서 필요한 글을 찾았다. 두 호출의 JSON 합계는 약 47KB로, 한 번에 top-10을 받은 약 69KB보다 작았다.
이 코퍼스에서는 top-k를 늘리는 것만으로 개선되지 않았다. 필요한 문서를 모두 찾은 질문은 top-3·5·10에서 똑같이 12/13개였지만, 전체 15질문의 반환량 중앙값은 약 22KB·35KB·70KB로 늘었다. 여러 목표를 섞은 질문이라면 후보 수를 늘리기 전에 목표별로 나눠볼 근거가 생겼다. 다만 분할 질문은 첫 결과를 본 뒤 만든 후속 시도이며, top-3이 항상 최선이라는 뜻은 아니다.
개인 블로그에서는 후보 수를 늘렸는데 근거가 빠지는 경우도 있었다. “1인 개발자 브랜치 전략”의 top-3에는 main과 feature/*를 설명한 청크가 있었지만, top-5에는 같은 글의 맺음말만 남고 설명 청크는 사라졌다. 두 설정을 한 번씩 다시 실행해도 같았다. 이 실행에서 top-5는 top-3에 두 청크를 덧붙인 결과가 아니었다. 필요한 근거를 찾았다면 후보 수를 늘리는 것보다 그 원문을 읽는 편이 확실했다.
파일 형식보다 변환된 본문이 중요했던 경우
Downloads의 HWP·DOCX·PDF·XLSX·PPTX 10개도 별도 사본으로 검색했다. exact 중복 HWP 1개가 제외돼 9개가 인덱싱됐다. 학생 과제 HWP의 데이터 수집처를 물었을 때는 top-1 청크에 EPSIS가 들어 있었다. RFP의 종료일 질문은 top-1에서 올바른 문서를 찾았지만 날짜는 없었고, top-3까지 받아야 날짜를 확인할 수 있었다.
권한 확인용 XLSX에서는 다른 문제가 드러났다. 파싱은 성공했지만 한국어가 &#숫자; 형태의 문자 참조로 남아 있었다. 파일 자체가 검색돼도 필요한 설명을 읽기 어려웠다. 시트와 행을 보존하는 마크다운으로 별도 변환해 다시 인덱싱하자, 두 질문 모두 top-1 청크에서 접근권한을 구성하는 조건과 교집합 설명을 찾았다. 이 비교에서는 문자 디코딩과 행 구조가 함께 바뀌었으므로 각각의 효과를 분리하지는 못했다.
같은 처리를 한 WBS는 달랐다. 특정 작업의 진행 상태를 묻는 두 질문은 원본 XLSX와 별도 변환한 마크다운 모두 top-10에서 대상 문서를 찾지 못했다. 따라서 이번 결과는 HWP의 본문·표를 찾아 읽는 용도에는 도움이 됐지만, 복잡한 엑셀을 그대로 질의할 수 있다는 근거는 되지 못했다.
사용 전 확인할 설정
문서 전송과 웹 검색
외부 LLM으로 full 모드를 실행하면 답변에 사용하는 문서 내용이 해당 서비스로 전달된다. 실험에 쓴 중간보고서에는 담당자 연락처도 들어 있었다. Lite 자체의 검색은 로컬에서 처리하더라도, 그 결과를 외부 에이전트에 넘기면 해당 모델 입력에 포함된다.
web_search는 기본으로 켜져 있다. 로컬 문서만 근거로 답하게 하려면 config.json에 "webSearch": {"enabled": false}를 설정한다.
로컬 실행 로그의 쿼리 필드는 본문 대신 길이를 기록한다. 검색 메모리와 원문 근거도 별도로 저장하므로, 로컬에 보관되는 정보는 실행 로그보다 많다.
설치 환경과 인터페이스
실험 환경의 MinSync 바이너리는 266MB였다. Java와 Rust 등의 설치 요건은 앞의 설치 절을 참고하면 된다. v2.5.2의 자동 배포 런타임 목록에는 Linux용 항목이 없었다. 이는 해당 자동 설치 경로의 제약이며, AutoRAG 전체가 Linux에서 실행되지 않는다는 뜻은 아니다.
웹 UI는 v2.5.2 설치 스킬 문서에서 개발 중으로 안내하고 있다. 이번 글의 설치와 검색은 CLI를 기준으로 했다.
정리
문서 변환과 인덱스를 준비해 두고 기존 에이전트에서 검색하려면 Lite를, AutoRAG에서 출처가 붙은 답변까지 받으려면 full을 선택할 수 있다.
처음 비교한 마크다운 폴더에서는 Claude Code에 grep을 시키는 쪽이 더 빨랐고 정답률은 같았다. 후속 실험에서 AutoRAG Lite가 유용했던 작업은 용어를 잊은 문서의 위치를 찾거나 HWP의 본문과 표를 검색하는 일이었다. 복합 질문은 나눠 묻는 편이 나았고, XLSX는 변환 결과에 따라 검색 가능한 내용이 달랐다. full 모드가 긴 문서의 중간 내용을 놓치고 원문과 다른 표현으로 답한 경우도 있었으므로, 날짜나 수치, 상태 이름처럼 정확해야 하는 값은 출처를 열어 대조해야 한다.
References
- AutoRAG (Marker-Inc-Korea/AutoRAG) - v2.5.2 기준. 상단 소개 이미지와 설계 원칙 이미지는 이 저장소 README의
assets/에서 가져왔다(MIT). 검색 흐름과 모드 비교 이미지는 본문 설명을 바탕으로 별도 제작했다 - MinSync (NomaDamas/MinSync) - hybrid 검색의 RRF 구현은
src/query.rs - jikji (NomaDamas/jikji)
- dupey
- agentdir: 원본은 그대로 두고 에이전트에게 작업하기 좋은 파일 구조를 따로 만들어주기
- MinSync: 파일이 바뀐 만큼만 다시 인덱싱하고, 청커로 그 비용을 좌우하기
- jikji: 에이전트의 파일 탐색 비용을 줄이는 로컬 인덱스
- dupey: 본문 기반 문서 중복 및 버전 판별